Suivre
Le compromis que personne ne veut faire
Quiconque a travaillé sur des projets SOC et SIEM suffisamment longtemps a vu la même décision se reproduire encore et encore lors des réunions budgétaires. Les équipes de sécurité sont poussées à faire un choix qui n’a rien à voir avec l’ingénierie de sécurité mais tout à voir avec les factures.
Option un : supprimer les sources de journaux. Coupez DNS. Supprimez la télémétrie des processus des points de terminaison. Supprimez les pistes d’audit cloud, ou échantillonnez-les à un niveau que la licence peut absorber. L’équipe survit au budget, et la surface de détection rétrécit tranquillement. Chaque source supprimée est un point aveugle avec lequel un adversaire n’a pas à composer, parce qu’elle n’a jamais été surveillée au départ.
Option deux : garder tout. Transférez la télémétrie brute vers les SIEM, les Data Lakes et les agents IA, et acceptez que la facture augmente en proportion directe de la quantité de journaux de l’entreprise. Migration cloud, Kubernetes, fournisseurs d’identité, prolifération de SaaS — chacun d’eux ajoute du volume, et aucun ne demande si le budget de sécurité a augmenté cette année.
Aucune des deux options n’est une stratégie. Elles sont toutes deux des conséquences de la même hypothèse architecturale : que la détection se produit après le stockage. Cette hypothèse est maintenant le principal moteur de coût dans le SOC moderne, et c’est celle que nous nous efforçons de supprimer.
Aujourd’hui, nous pouvons partager un ROI validé sur une troisième approche : mettre un moteur de détection des menaces complet à l’intérieur du pipeline de données, avant que les niveaux coûteux ne voient jamais les données.
Ce que fait réellement Prime Detect
SOC Prime Detect évalue 100 % de votre télémétrie en streaming à la vitesse du fil. Pas un échantillon. Pas un sous-ensemble filtré choisi par une règle de contrôle des coûts il y a six mois que personne n’a revisité depuis. Tout cela, au fur et à mesure qu’il se déplace.
Il le fait en appliquant une logique Sigma organisée au niveau du pipeline — l’étape de transport entre vos collecteurs et vos destinations. Trois choses découlent de ce placement :
Niveau 1 — réduction du bruit. Prime Detect filtre 93 % du bruit des journaux bruts avant qu’il n’atteigne une destination payante. Authentifications routinières réussies, télémétrie de processus bavarde, vérifications de santé, l’énorme bourdonnement de fond que chaque environnement d’entreprise produit et qu’aucun analyste n’a jamais ouvert. Les événements sont évalués par rapport à la logique de détection en premier, puis écartés ou acheminés à moindre coût, plutôt que d’être payés à des taux d’ingestion premium dans l’espoir qu’ils pourraient avoir de l’importance plus tard.
Niveau 2 — corrélation. Les correspondances isolées ne sont pas des détections. Prime Detect utilise les corrélations Sigma, exprimées sous forme de règles Sigma de haut niveau, pour assembler des correspondances individuelles en chaînes d’attaque à travers les sources et à travers le temps. C’est là qu’une seule requête LDAP suspect et une création de service inhabituelle cessent d’être deux événements de faible confiance et deviennent une séquence de haute confiance.
Niveau 3 — livraison du signal. Ce qui atteint le sommet de la pile est compressé à 7 PPM — 0,000007 du flux original. C’est le matériel remis aux agents IA de niveau 3 : sept événements par million, déjà corrélés, déjà contextualisés, déjà dignes d’analyse.
Le point clé est que rien n’est jeté avant d’être examiné. Le contrôle des coûts traditionnel élimine les données à l’aveugle. Prime Detect inspecte tout et ne transmet que ce qui mérite sa place en aval.
Les chiffres, tels que mesurés avec les clients Enterprise
Le tableau ci-dessous montre les économies validées sur des volumes d’ingestion de 100 Go/jour à 10 To/jour, répartis là où le coût se situe dans la pile.
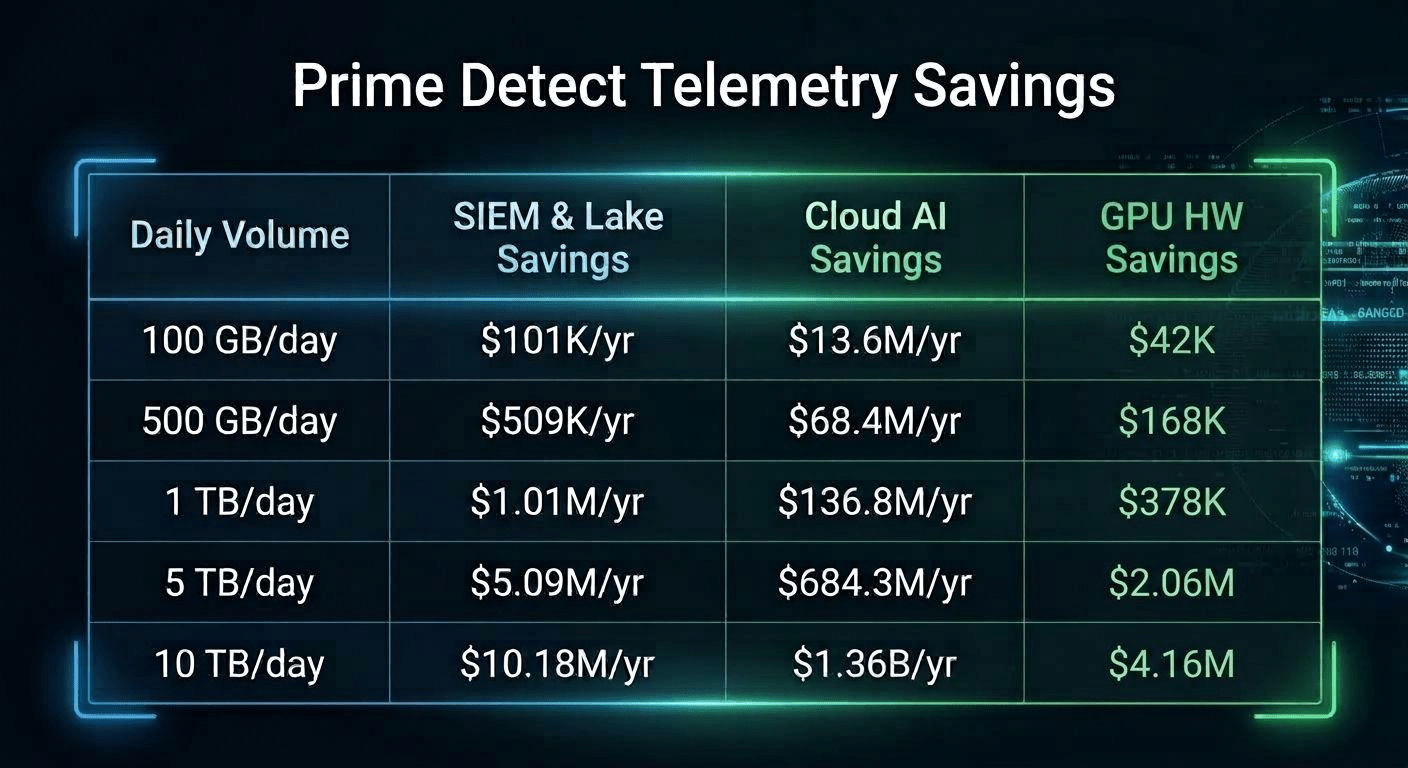
Trois lignes de coûts distinctes méritent d’être lues attentivement, car elles se comportent très différemment.
Les économies de SIEM et de Data Lake sont les plus familières. Elles évoluent linéairement avec le volume et ce sont celles que la plupart des responsables de la sécurité suivent déjà. À 1 To/jour, une réduction de 93 % de ce qui atteint le niveau payant vaut approximativement un million de dollars par an. À 10 To/jour, cela en vaut dix.
Les économies d’IA cloud sont là où l’arithmétique devient vraiment inconfortable pour quiconque planifie un SOC IA. Les coûts des jetons augmentent avec le volume de texte qu’un modèle est invité à lire. Pointer un LLM vers de la télémétrie brute signifie payer pour chaque battement de cœur et chaque connexion réussie, à des prix d’inférence, pour toujours. La différence entre raisonner sur un flux brut et raisonner sur un signal 7 PPM est la différence entre une ligne budgétaire et une impossibilité. À 1 To/jour, cette différence est de 136,8 M$ par an.
Les économies de matériel GPU s’appliquent aux équipes exécutant des modèles sur leur propre infrastructure. L’économie est plus petite en termes absolus mais structurellement importante : elle modifie ce que vous devez acheter à l’avance. Une stratégie de détection nécessitant une ferme de GPU avant de produire sa première alerte est une stratégie que la plupart des organisations ne parviendront jamais à financer.
Ce que cela signifie pour votre pile
1. Arrêtez de laisser le volume d’ingestion dicter votre stratégie de sécurité. Les frais logiciels, matériels et IA en aval peuvent être réduits jusqu’à 93 %. Plus important encore, la décision de savoir quelles sources de journaux conserver revient à être une décision d’ingénierie de détection plutôt qu’une décision d’achat. La couverture cesse d’être rationnée.
2. Permettre une détection continue sur 100 % des journaux non analysés. La détection au niveau du pipeline ne dépend pas d’une source normalisée, mappée et intégrée d’abord. Les règles Sigma s’exécutent contre le flux à son arrivée, ce qui signifie que les nouvelles sources contribuent à la détection dès le premier jour plutôt qu’après un projet de parsing. Il évite également une contrainte qui plafonne discrètement de nombreux programmes matures : les limites d’exécution des règles SIEM. Les équipes retirent régulièrement des règles fonctionnelles pour faire de la place à de nouvelles. Déplacer l’évaluation dans le pipeline permet de supprimer ce plafond, et cela sans ensevelir les analystes ou les ingénieurs de détection sous un volume d’alertes supplémentaire, car la corrélation se produit avant la livraison, pas après.
3. Exécutez des agents autonomes SOC IA sur des chaînes d’attaque à haute fidélité. Les agents IA sont extrêmement performants pour raisonner sur des preuves structurées et corrélées, et extrêmement coûteux lorsqu’ils sont sollicités pour trier du bruit brut. Leur fournir un signal 7 PPM corrélé est ce qui rend la gestion autonome économiquement viable sans un budget de jetons d’un million de dollars ou une salle de serveurs remplie de GPU.
Pourquoi Sigma, et pourquoi le niveau du pipeline
Deux choix de conception réalisent l’essentiel du travail ici, et les deux sont délibérés.
Sigma est un format de détection ouvert, neutre sur le plan des fournisseurs, avec un important corpus public de logique activement maintenu. Utiliser une logique Sigma organisée au niveau du pipeline signifie que le contenu de détection est portable : il n’est pas verrouillé dans le langage de requête de la plate-forme que vous avez achetée, et il n’a pas besoin d’être réécrit lorsqu’une destination change. Le contenu que votre équipe écrit et le contenu que la communauté publie s’exécutent au même endroit, contre le même flux.
Les corrélations Sigma étendent ce modèle de la correspondance d’événements uniques à la logique de séquence et de seuil. Les règles Sigma de haut niveau permettent au pipeline de décider qu’un cluster d’événements individuellement peu remarquables constitue une chaîne d’attaque digne d’être escaladée — et, tout aussi important, qu’un événement correspondant sans contexte environnant ne l’est pas.
Le niveau du pipeline est important car c’est le seul endroit dans l’architecture où chaque événement est garanti de passer exactement une fois, en mouvement, avant que tout coût de stockage ou de calcul n’ait été engagé. La détection à cet endroit n’est pas une version moins chère de ce que fait le SIEM. C’est le même travail effectué au seul point où il est encore gratuit de le faire.
Voyez par vous-même
Le compromis entre couverture et coût n’a jamais été une loi de la nature. C’était un artefact de l’endroit où la détection se trouvait dans la pile. Déplacez la détection en amont, vers le pipeline, et les deux côtés de ce compromis s’améliorent en même temps : plus de votre télémétrie est examinée, et moins de celle-ci est payée deux fois.
Si vous voulez ce ROI pour votre propre pile de sécurité, prenez contact — ou consultez une démo en direct de la façon dont Prime Detect fonctionne. Sans conditions.